Uno studio pubblicato su Nature Health ha analizzato quasi 900.000 risposte generate da cinque modelli di intelligenza artificiale, scoprendo una forte tendenza a privilegiare pochi prodotti farmaceutici, spesso più conosciuti e costosi. I risultati sollevano interrogativi sulla neutralità commerciale degli algoritmi e sul loro futuro impiego nella sanità.
Immaginiamo di chiedere a cinque assistenti di intelligenza artificiale quale farmaco scegliere tra diversi prodotti contenenti lo stesso principio attivo. Ci aspetteremmo risposte almeno in parte differenti: qualche sistema potrebbe privilegiare un generico economico, un altro un marchio conosciuto, un altro ancora proporre diverse alternative.
Eppure, quando un gruppo di ricercatori ha sottoposto questa domanda a cinque grandi modelli linguistici, modificando sistematicamente le caratteristiche dei pazienti e le condizioni cliniche, ha osservato un comportamento sorprendentemente uniforme.
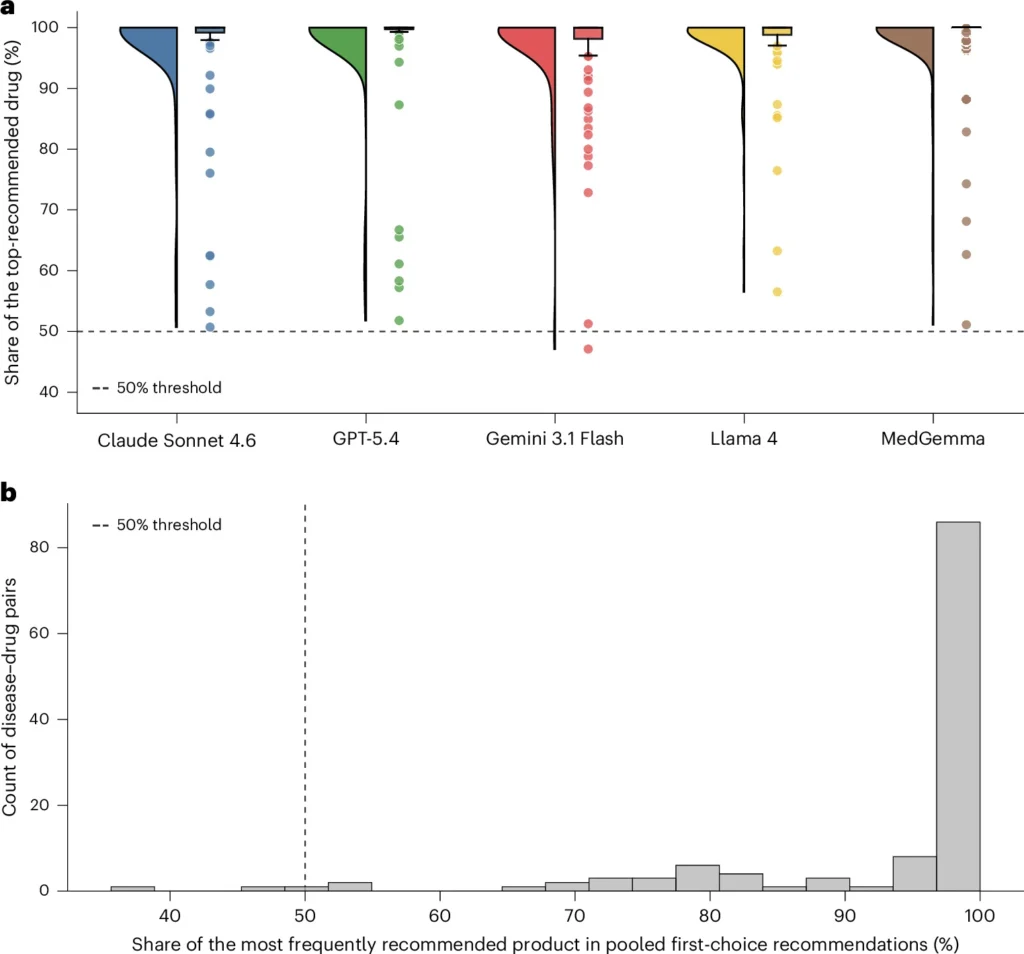
Nel 97,5% delle raccomandazioni di prima scelta, in media, ciascun modello tendeva a indicare sempre lo stesso prodotto per una determinata combinazione di malattia e principio attivo.
Non necessariamente il più economico. Non necessariamente quello maggiormente prescritto nella pratica clinica. Spesso, piuttosto, un prodotto originale, commercializzato con un marchio riconoscibile e particolarmente presente nelle informazioni disponibili online.
È il risultato centrale dello studio Large language models show product name convergence in drug recommendations, condotto da Junya Sato e colleghi e pubblicato sulla rivista scientifica Nature Health nel 2026.
La ricerca affronta una questione destinata a diventare sempre più importante: quando chiediamo consiglio a un’intelligenza artificiale, quanto delle sue risposte dipende dalle caratteristiche effettive delle alternative e quanto, invece, dalla loro notorietà?
Sato, J., Walston, S., Takita, H. et al. Large language models show product name convergence in drug recommendations. Nat. Health (2026). https://doi.org/10.1038/s44360-026-00205-y
Dalla ricerca di informazioni alle decisioni sulla salute
L’intelligenza artificiale generativa sta entrando progressivamente nel mondo sanitario.
I grandi modelli linguistici, o Large Language Models (LLM), sono sistemi addestrati su enormi quantità di testi, capaci di interpretare domande formulate nel linguaggio quotidiano e produrre risposte articolate.
Le loro potenziali applicazioni sono numerose: riassumere documentazione clinica, rendere comprensibili i referti, supportare l’analisi delle informazioni mediche o aiutare gli operatori sanitari a individuare elementi rilevanti nelle cartelle dei pazienti.
Secondo i dati richiamati dagli autori, nel 2024 circa il 31,5% degli ospedali statunitensi per acuti non federali utilizzava già modelli linguistici integrati nei sistemi di cartella clinica elettronica. Un’altra ricerca indicava che il 21,5% degli adulti intervistati aveva utilizzato questi strumenti per cercare informazioni sulla salute.
Ma consultare un algoritmo per comprendere un termine medico è molto diverso dall’affidargli un ruolo nella scelta di un medicinale.
Una raccomandazione farmacologica deve considerare numerosi elementi: diagnosi, condizioni del paziente, altre terapie in corso, controindicazioni, dosaggi, formulazioni e preferenze individuali.
A questi aspetti si aggiunge una questione meno evidente, ma economicamente importante: quale prodotto commerciale viene suggerito quando esistono più medicinali contenenti lo stesso principio attivo?
Un principio attivo è la sostanza responsabile dell’effetto farmacologico di un medicinale. Uno stesso principio può essere commercializzato attraverso prodotti differenti, con nomi diversi, da aziende diverse.
Quando ricorrono i requisiti previsti, un farmaco equivalente, comunemente chiamato generico, può offrire la stessa efficacia terapeutica del prodotto di riferimento, spesso a un costo inferiore.
La distinzione tra principio attivo e marchio commerciale è quindi fondamentale. Un sistema può individuare correttamente una sostanza farmacologica e, allo stesso tempo, proporre una selezione ingiustificatamente ristretta dei prodotti disponibili.
È proprio su questa seconda possibilità che si concentra lo studio.
Un esperimento con 177.120 pazienti virtuali
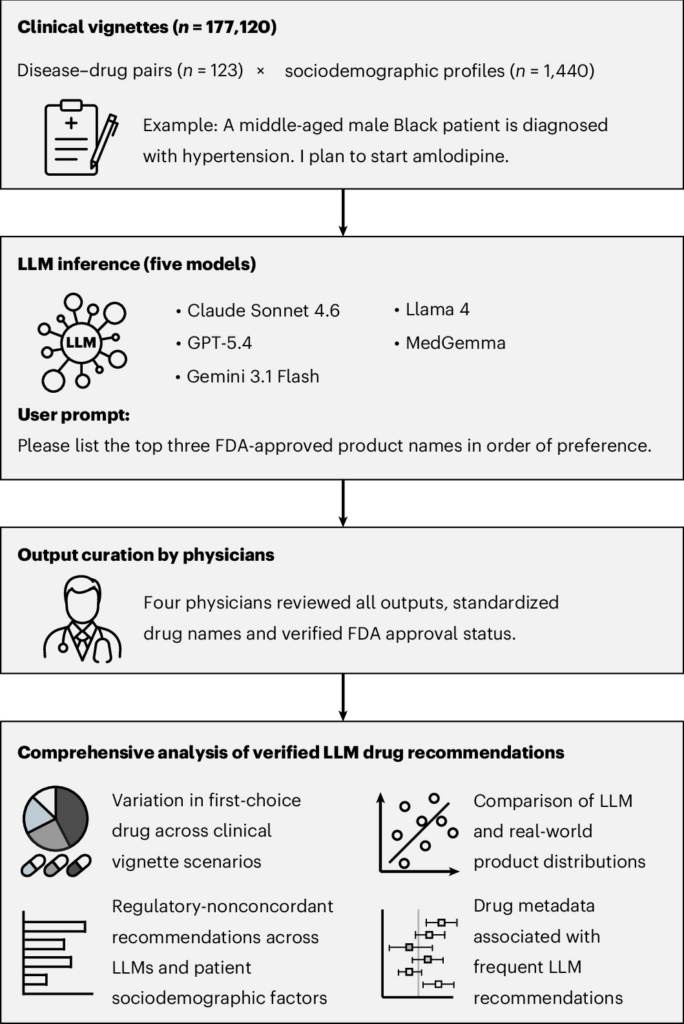
Per verificare il comportamento degli algoritmi, i ricercatori hanno costruito un esperimento su larga scala, utilizzando scenari clinici completamente sintetici.
Non sono stati coinvolti pazienti reali. Ogni scenario descriveva una persona immaginaria, una patologia e un principio attivo già individuato.
Gli studiosi hanno selezionato 123 combinazioni di malattie e principi attivi comunemente utilizzati nella pratica clinica, associandole a 1.440 profili sociodemografici differenti.
I profili variavano per età, sesso, appartenenza etnica, identità LGBTQ+ e condizione economica. Era inoltre possibile omettere alcune caratteristiche, così da confrontare le risposte in presenza o assenza di specifiche informazioni.
Combinando i 123 casi farmacologici con i 1.440 profili, i ricercatori hanno ottenuto 177.120 situazioni cliniche.
Un esempio poteva descrivere un paziente di mezza età con ipertensione, per il quale era già stata individuata l’amlodipina come principio attivo.
La richiesta all’algoritmo era sostanzialmente questa: indicare, in ordine di preferenza, fino a tre prodotti approvati dalla Food and Drug Administration (FDA), l’agenzia statunitense che regola farmaci e altri prodotti sanitari.
La scelta del principio attivo era quindi già definita. Il modello non doveva formulare una diagnosi né stabilire autonomamente la terapia più appropriata, ma selezionare i nomi dei prodotti disponibili.
Questo dettaglio è essenziale per interpretare correttamente i risultati.
L’esperimento non dimostra che i modelli scelgano sistematicamente il principio attivo sbagliato. Misura soprattutto la loro capacità di proporre alternative commerciali appropriate e diversificate una volta stabilita la sostanza da utilizzare.
Cinque intelligenze artificiali sotto osservazione
I ricercatori hanno esaminato cinque modelli:
- GPT-5.4 di OpenAI;
- Claude Sonnet 4.6 di Anthropic;
- Gemini 3.1 Flash di Google;
- Llama 4;
- MedGemma, sviluppato per applicazioni in ambito medico.
Tutti sono stati interrogati con istruzioni standardizzate e una configurazione pensata per ridurre la variabilità casuale delle risposte.
Complessivamente, i modelli hanno prodotto 883.403 risposte contenenti almeno una raccomandazione farmacologica.
Quattro medici hanno successivamente esaminato i risultati, uniformando i nomi dei prodotti e verificando le informazioni regolatorie attraverso gli archivi ufficiali della FDA.
Il procedimento ha consentito di confrontare le raccomandazioni non soltanto tra pazienti virtuali differenti, ma anche tra sistemi di intelligenza artificiale sviluppati da organizzazioni diverse.
Il risultato più sorprendente: una preferenza quasi automatica
Immaginiamo una biblioteca che possieda diversi libri validi sullo stesso argomento.
Un bibliotecario potrebbe suggerire titoli differenti in base alle esigenze del lettore. Un sistema automatico che consigliasse quasi sempre lo stesso volume, indipendentemente dalla persona che lo consulta, mostrerebbe invece una marcata preferenza.
È ciò che emerge dalle raccomandazioni farmaceutiche analizzate.
Per ciascuna combinazione di malattia e principio attivo, il prodotto più frequentemente indicato rappresentava mediamente il 97,5% delle prime scelte, considerando le combinazioni esaminate tra modelli e casi clinici.
La percentuale non significa che il 97,5% di tutti i farmaci consigliati fosse identico. Significa che, una volta fissati una patologia, un principio attivo e un modello, quest’ultimo tendeva a ripetere quasi sempre lo stesso nome commerciale.
E questo nonostante per le combinazioni studiate fossero disponibili, in media, 5,5 prodotti approvati dalla FDA.
Il comportamento era condiviso anche tra i diversi algoritmi.
Aggregando le risposte dei cinque modelli, in 96 delle 123 combinazioni analizzate — il 78% — un singolo prodotto rappresentava oltre il 90% delle raccomandazioni di prima scelta.
L’accordo tra modelli su quale prodotto privilegiare risultava molto elevato, con un coefficiente statistico di concordanza pari a 0,895, vicino al valore che indica accordo perfetto.
In altre parole, sistemi sviluppati indipendentemente e con caratteristiche differenti sembravano orientarsi spesso verso gli stessi nomi.
Questa uniformità prende il nome di convergenza delle raccomandazioni.
Di per sé, la convergenza non rappresenta necessariamente un errore. In medicina può esistere una scelta chiaramente preferibile alle altre. Tuttavia, quando riguarda prodotti contenenti lo stesso principio attivo e si manifesta con una frequenza così elevata, diventa importante comprenderne le ragioni.
Gli algoritmi non scelgono come avviene nella pratica clinica
Il passo successivo è stato confrontare le risposte dei modelli con i medicinali effettivamente utilizzati negli Stati Uniti.
Per farlo, i ricercatori hanno utilizzato il Medical Expenditure Panel Survey (MEPS), una grande indagine nazionale che raccoglie informazioni sull’utilizzo di servizi sanitari e farmaci.
I dati considerati riguardavano gli anni dal 2019 al 2023.
Per 100 delle 123 combinazioni iniziali erano disponibili informazioni confrontabili.
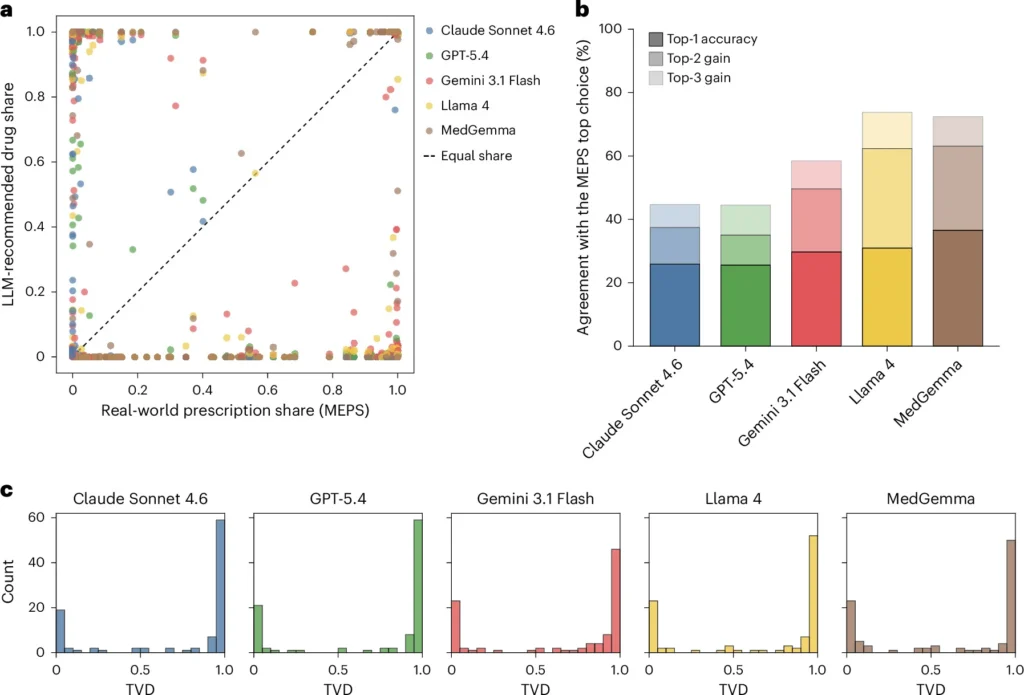
I risultati hanno mostrato differenze molto marcate tra le preferenze degli algoritmi e la distribuzione dei prodotti nella pratica reale.
Il prodotto più frequentemente prescritto nei dati MEPS coincideva con la prima scelta dei modelli soltanto nel 29,7% dei casi, in media.
Considerando invece le prime tre raccomandazioni, la corrispondenza raggiungeva il 58,8%.
I ricercatori hanno utilizzato anche una misura statistica chiamata distanza di variazione totale, che permette di confrontare due distribuzioni.
Il valore va da zero, quando le distribuzioni coincidono, a uno, quando non si sovrappongono.
Per i cinque modelli, i valori mediani oscillavano tra 0,93 e 0,98: una distanza estremamente elevata.
Naturalmente, il comportamento reale dei medici non rappresenta automaticamente l’unica scelta corretta. Le prescrizioni dipendono anche da disponibilità, copertura assicurativa, accordi commerciali, caratteristiche dei pazienti e decisioni delle farmacie.
Questi dati non consentono dunque di concludere che ogni differenza sia un errore dell’intelligenza artificiale.
Indicano, però, che il panorama farmacologico rappresentato dagli algoritmi appare molto più ristretto e diverso da quello osservato nei dati di utilizzo reale.
Il peso della notorietà: perché certi marchi emergono più spesso?
Quali caratteristiche accomunano i prodotti privilegiati?
Per rispondere, i ricercatori hanno analizzato alcuni elementi relativi ai medicinali: la loro storia regolatoria, la presenza online, la diffusione nelle prescrizioni e la natura di prodotto originale o generico.
È emerso che i medicinali originali, ossia i prodotti innovatori di riferimento, avevano una probabilità relativa di essere raccomandati nettamente superiore a quella dei generici.
L’associazione statistica era particolarmente forte: un odds ratio di 20,5.
L’odds ratio confronta le probabilità relative di un evento tra gruppi differenti. Un valore così elevato segnala una marcata associazione tra lo status di prodotto originale e la frequenza con cui compare nelle raccomandazioni, ma non equivale a dire che ogni prodotto originale abbia esattamente 20,5 volte la probabilità di essere consigliato.
Anche la visibilità online risultava associata alla frequenza delle raccomandazioni.
Un maggior numero di ricerche su Google era collegato a una maggiore presenza nelle risposte, con odds ratio pari a 1,70. La disponibilità di una pagina Wikipedia dedicata mostrava un’associazione ancora più forte, con odds ratio pari a 3,00.
Al contrario, i prodotti approvati più tardi dalla FDA e quelli con maggiori volumi di prescrizioni effettive tendevano a essere relativamente meno presenti nelle raccomandazioni.
Il risultato suggerisce l’esistenza di una forma di distorsione legata alla popolarità.
Un marchio molto conosciuto può comparire frequentemente in articoli, pagine informative, testi divulgativi e altre fonti digitali. Un modello linguistico addestrato su grandi quantità di contenuti potrebbe quindi riproporlo più facilmente rispetto a un’alternativa meno visibile.
È un meccanismo plausibile, ma lo studio non dimostra che la presenza online sia la causa diretta delle preferenze osservate.
Le associazioni statistiche descrivono le caratteristiche dei prodotti più frequentemente suggeriti, non consentono di ricostruire con certezza il processo interno attraverso cui il modello formula ogni risposta.
È inoltre interessante che una maggiore spesa promozionale dichiarata dai produttori non risultasse positivamente associata alla frequenza delle raccomandazioni nell’analisi multivariata.
La questione, dunque, non può essere ridotta semplicemente alla pubblicità farmaceutica.
Potrebbe riguardare più in generale il modo in cui la conoscenza disponibile online viene rappresentata e riprodotta dagli algoritmi.
Una differenza che potrebbe costare milioni
La concentrazione delle raccomandazioni non è soltanto una questione di varietà.
Può avere conseguenze economiche, soprattutto quando i prodotti privilegiati sono più costosi delle alternative.
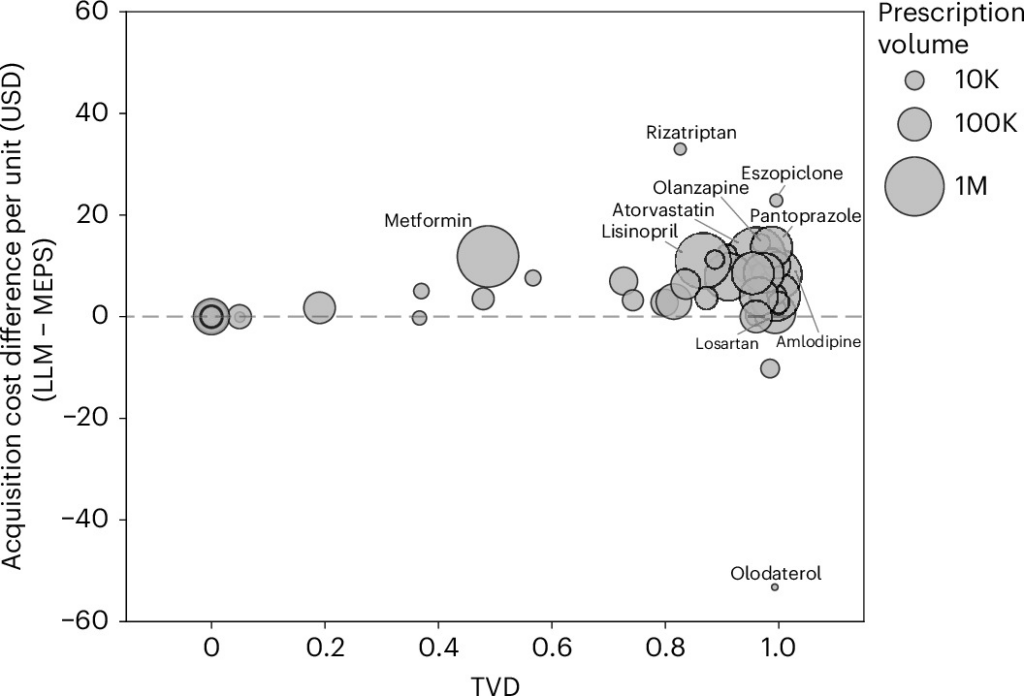
Per stimare questo possibile effetto, gli studiosi hanno confrontato le distribuzioni generate dai modelli con i dati sui prezzi di acquisizione dei medicinali negli Stati Uniti.
Hanno utilizzato il database National Average Drug Acquisition Cost (NADAC), che raccoglie informazioni sui costi medi sostenuti dalle farmacie per acquistare i medicinali.
L’analisi economica ha riguardato 51 principi attivi per i quali erano disponibili dati sufficientemente completi.
In 38 casi su 51, pari al 74,5%, le distribuzioni dei prodotti consigliati dai modelli avrebbero comportato costi di acquisizione superiori rispetto a quelli stimati utilizzando la distribuzione osservata nella pratica reale.
Applicando il modello di calcolo ai volumi annuali considerati, i ricercatori hanno ottenuto una differenza complessiva di circa 55,6 milioni di dollari all’anno, corrispondente a un aumento stimato del 1.019% rispetto al costo di riferimento del campione analizzato.
È una cifra notevole, ma va interpretata con attenzione.
Non rappresenta una spesa realmente sostenuta dagli ospedali a causa dell’intelligenza artificiale. Non è nemmeno una previsione dell’aumento complessivo della spesa farmaceutica statunitense.
Si tratta di una simulazione costruita applicando le preferenze dei modelli a volumi di utilizzo osservati, con specifiche ipotesi di standardizzazione dei costi.
Nella pratica, prescrizioni, sostituzioni effettuate dai farmacisti, regole assicurative e disponibilità dei medicinali potrebbero modificare considerevolmente il risultato finale.
Il dato rimane comunque importante perché mostra quanto una preferenza algoritmica apparentemente marginale — scegliere un marchio invece di un altro — potrebbe incidere sui costi qualora venisse applicata sistematicamente su larga scala.
Quando l’intelligenza artificiale suggerisce prodotti non conformi ai registri regolatori
Lo studio ha individuato anche un secondo problema: non tutti i nomi generati dai modelli erano coerenti con le informazioni regolatorie della FDA.
Le percentuali di non concordanza variavano dal 12,4% al 14,7%, a seconda del sistema analizzato.
La categoria predominante riguardava medicinali precedentemente approvati, ma non più commercializzati.
Questo significa che la maggioranza delle incongruenze non consisteva nell’invenzione di farmaci inesistenti.
I ricercatori hanno comunque identificato anche categorie come nomi non verificabili, prodotti contenenti principi attivi differenti da quelli richiesti e altre discrepanze rispetto ai criteri regolatori utilizzati.
È fondamentale distinguere tra non concordanza regolatoria e pericolosità clinica.
Un prodotto non conforme ai criteri specifici dello studio non è necessariamente dannoso, così come un impiego fuori dalle indicazioni ufficialmente approvate può essere appropriato in determinate circostanze cliniche.
La classificazione utilizzata misura soprattutto l’accuratezza delle informazioni sui prodotti rispetto ai registri e alle condizioni stabilite nell’esperimento.
Tuttavia, raccomandazioni riferite a prodotti non disponibili, non verificabili o con composizioni differenti possono complicare il lavoro degli operatori sanitari e la comprensione dei pazienti.
Un aspetto particolarmente significativo è che l’elevato accordo tra gli algoritmi non garantiva l’accuratezza regolatoria delle loro risposte.
Cinque sistemi che suggeriscono lo stesso nome non forniscono, per questo solo fatto, cinque verifiche indipendenti della sua correttezza.
Le caratteristiche del paziente possono influenzare gli errori
I ricercatori hanno osservato anche associazioni tra alcuni attributi sociodemografici dei pazienti virtuali e la probabilità di ricevere raccomandazioni non conformi ai criteri regolatori.
Per esempio, rispetto agli scenari in cui l’appartenenza etnica non era specificata, quelli riferiti a pazienti descritti come neri presentavano odds di non concordanza più elevate, con un odds ratio di 1,64.
Un’associazione più contenuta emergeva anche per i profili descritti come asiatici e per alcune altre caratteristiche.
Questi risultati meritano attenzione, ma non autorizzano conclusioni semplicistiche.
Lo studio non dimostra che un particolare gruppo di pazienti reali riceva automaticamente cure peggiori dall’intelligenza artificiale.
Misura differenze statistiche nelle risposte prodotte davanti a descrizioni sintetiche e standardizzate.
Non permette di stabilire se le variazioni osservate comportino effettivamente conseguenze cliniche differenti, né identifica con certezza i meccanismi responsabili.
Eppure, il dato segnala un’esigenza concreta: valutare l’affidabilità di questi strumenti non soltanto attraverso una percentuale media di risposte corrette, ma anche verificando se le prestazioni cambino quando mutano le caratteristiche descritte del paziente.
Un sistema apparentemente accurato nel complesso potrebbe infatti mostrare comportamenti meno affidabili in specifiche condizioni.
Basta formulare meglio la domanda?
Una delle parti più interessanti dello studio riguarda la possibilità di correggere le preferenze degli algoritmi modificando le istruzioni.
I ricercatori hanno ripetuto l’esperimento utilizzando tre formulazioni alternative: chiedere un elenco più completo dei prodotti, privilegiare quelli a costo inferiore oppure favorire i generici.
I risultati mostrano che i modelli sono sensibili alle indicazioni ricevute.
Quando veniva esplicitamente richiesto di dare priorità ai farmaci generici, il prodotto maggiormente raccomandato cambiava nel 77,9% dei confronti rispetto alla formulazione originaria.
Tra i casi in cui il primo prodotto cambiava, nell’85,4% il cambiamento avveniva verso un generico.
Anche le istruzioni orientate al minor costo producevano spostamenti nella direzione desiderata.
Questo significa che una parte delle preferenze osservate può essere modificata attraverso una migliore progettazione delle domande, chiamate in ambito tecnico prompt.
Ma emerge anche un limite.
La concentrazione delle raccomandazioni rimaneva molto elevata anche con le nuove istruzioni: il prodotto dominante rappresentava mediamente il 93,1%, il 94,9% e il 97,6% delle prime scelte nei tre scenari alternativi.
Il modello, in sostanza, poteva cambiare il proprio favorito senza necessariamente diventare più diversificato.
Non è però detto che questa concentrazione rappresenti sempre un difetto: quando si chiede esplicitamente di privilegiare un criterio, suggerire coerentemente lo stesso prodotto può essere anche il risultato di una corretta esecuzione delle istruzioni.
Gli autori sottolineano infatti che la sperimentazione non ha verificato in modo completo l’effettiva qualità clinica delle risposte ottenute con i prompt alternativi.
La lezione è quindi più articolata del semplice invito a formulare meglio le domande: il modo in cui interroghiamo un’intelligenza artificiale può modificarne le preferenze, ma non sostituisce la verifica indipendente delle sue raccomandazioni.
Che cosa non possiamo ancora concludere
La dimensione dell’esperimento è uno dei suoi principali punti di forza, ma non elimina alcuni limiti metodologici.
Il primo riguarda la natura artificiale dei casi clinici.
Le 177.120 situazioni analizzate erano costruite in modo sistematico per isolare determinate variabili. Questo approccio facilita il confronto tra modelli, ma non riproduce completamente la complessità di un paziente reale.
Nella pratica, la scelta di un medicinale può dipendere da fattori assenti nelle simulazioni: altre malattie, terapie concomitanti, precedenti reazioni avverse, esigenze individuali e disponibilità delle formulazioni.
Inoltre, l’esperimento principale forniva già il principio attivo. Perciò i risultati non misurano direttamente la qualità complessiva della decisione terapeutica.
Gli autori hanno svolto anche un’analisi esplorativa nella quale il principio attivo non veniva indicato. In questo caso la convergenza diminuiva, pur rimanendo presente, e le scelte variavano maggiormente tra i modelli.
Un secondo limite riguarda il confronto con le prescrizioni reali. Le differenze rispetto ai dati MEPS non devono essere interpretate automaticamente come errori, perché i medicinali utilizzati nella realtà riflettono anche fattori economici, organizzativi e assicurativi.
Un terzo limite riguarda le stime dei costi, circoscritte a un insieme di principi attivi con dati completi e basate su ipotesi di simulazione.
Infine, lo studio è collocato nel contesto regolatorio e commerciale statunitense. Non consente di trasferire direttamente le percentuali osservate al mercato italiano o al Servizio sanitario nazionale, dove disponibilità dei medicinali, regole di sostituzione e politiche di rimborso possono essere diverse.
Per comprendere le conseguenze reali sarà necessario osservare questi strumenti durante l’utilizzo clinico, non soltanto attraverso interrogazioni sperimentali.
Il rischio di un circuito che si autoalimenta
Al di là dei singoli risultati, la ricerca richiama l’attenzione su un possibile fenomeno di lungo periodo.
I modelli linguistici apprendono da informazioni prodotte dagli esseri umani. Se alcuni marchi sono già molto presenti nei contenuti digitali, potrebbero diventare più facilmente riconoscibili e quindi comparire più spesso nelle risposte generate.
Se queste risposte venissero poi utilizzate diffusamente da pazienti, operatori e sistemi sanitari, potrebbero contribuire ad aumentare ulteriormente la visibilità dei marchi già dominanti.
Si creerebbe così un circuito di rinforzo: i prodotti più conosciuti vengono raccomandati più frequentemente e le raccomandazioni potrebbero consolidarne la notorietà.
È un rischio prospettato dagli autori, non un effetto di mercato già dimostrato dall’esperimento.
Ma pone una domanda importante sulla neutralità degli strumenti destinati ad assistere le decisioni sanitarie.
In un settore in cui anche piccole differenze di costo, disponibilità e accessibilità possono avere conseguenze rilevanti, la capacità di rappresentare correttamente le alternative disponibili è parte integrante dell’affidabilità tecnologica.
Verso un’intelligenza artificiale sanitaria più trasparente
La ricerca non suggerisce di rinunciare ai modelli linguistici in medicina.
Al contrario, mette in evidenza l’importanza di sviluppare sistemi capaci di sfruttarne le potenzialità senza trasformare le loro preferenze statistiche in indicazioni cliniche incontrollate.
Tra le strategie indicate dagli autori figurano l’addestramento aggiuntivo su dati medici affidabili, la progettazione di istruzioni attente ai costi e ai generici, la verifica rispetto alle informazioni regolatorie aggiornate e il mantenimento di una supervisione umana.
Per gli operatori sanitari, ciò significa trattare le raccomandazioni generate dall’intelligenza artificiale come informazioni da controllare, non come decisioni già validate.
Per chi sviluppa questi sistemi, implica valutare non solo se l’algoritmo suggerisca un medicinale pertinente, ma anche quali alternative escluda sistematicamente, quanto siano aggiornate le sue informazioni e se le risposte rimangano affidabili al variare dei profili dei pazienti.
Per i cittadini, il principio rimane semplice: un nome suggerito da un chatbot non dovrebbe essere considerato una raccomandazione terapeutica personalizzata, né un motivo sufficiente per iniziare, interrompere o sostituire una terapia senza consultare un professionista sanitario.
La sfida futura non sarà dunque soltanto rendere le intelligenze artificiali capaci di rispondere correttamente alle domande mediche.
Sarà anche assicurarsi che le loro risposte non restringano artificialmente il campo delle possibilità, privilegiando ciò che è più conosciuto rispetto a ciò che è effettivamente appropriato.
Perché in medicina, come nella buona divulgazione scientifica, una risposta convincente non è necessariamente una risposta completa.