Un gruppo di ricercatori di Google DeepMind ha sviluppato SynthIDBio, un sistema che permette di inserire marcatori digitali nelle proteine progettate dall’intelligenza artificiale e nelle loro strutture tridimensionali, senza comprometterne le proprietà essenziali nei test effettuati. Pubblicata su Nature, la ricerca apre nuove prospettive per la tracciabilità delle biotecnologie, la sicurezza biologica e l’affidabilità dei dati scientifici.
Stutz, D., Cowen-Rivers, A.I., Ortiz-Jimenez, G. et al. Function-preserving watermarking of AI-generated proteins. Nature (2026). https://doi.org/10.1038/s41586-026-10965-y
Una firma invisibile nel linguaggio della vita
Immaginiamo che un laboratorio riceva la sequenza di una proteina completamente nuova. Potrebbe essere una molecola progettata per riconoscere un bersaglio terapeutico, uno strumento destinato alla diagnostica oppure un componente di un esperimento di biologia sintetica. La sequenza appare perfettamente plausibile: una successione di amminoacidi, le unità fondamentali che costituiscono le proteine, organizzata secondo le regole della chimica e della biologia.
Ma c’è una domanda alla quale quella sequenza, da sola, non permette necessariamente di rispondere: chi l’ha progettata, e soprattutto come?
È stata ottenuta attraverso un processo biologico naturale? Deriva da una modifica sperimentale di una proteina conosciuta? Oppure è stata generata da un sistema di intelligenza artificiale?
La distinzione sta diventando sempre più importante. Gli algoritmi generativi non si limitano più a prevedere la forma delle molecole esistenti: possono contribuire alla progettazione di proteine artificiali dotate di caratteristiche specifiche, accelerando attività che fino a pochi anni fa richiedevano lunghi cicli di sperimentazione.
La crescente capacità di creare nuove molecole introduce tuttavia un problema di tracciabilità. Una sequenza proteica non conserva automaticamente informazioni verificabili sugli strumenti che hanno contribuito alla sua progettazione.
Una possibile soluzione arriva da una ricerca condotta da Google DeepMind e pubblicata sulla rivista Nature con il titolo Function-preserving watermarking of AI-generated proteins.
Gli autori presentano SynthIDBio, una famiglia di tecniche che permette di incorporare una sorta di firma digitale invisibile nei prodotti dell’intelligenza artificiale applicata alla biologia.
L’aspetto più significativo non è soltanto la possibilità di riconoscere questa firma, ma la dimostrazione che, nei sistemi sperimentati, essa può essere introdotta senza alterare in modo sostanziale le caratteristiche biologiche o strutturali che rendono utile il risultato.
Non si tratta ancora di una tecnologia capace di certificare ogni proteina sintetica, ma di un passo concreto verso un problema destinato ad accompagnare la diffusione dell’intelligenza artificiale nelle scienze della vita: come riconoscere l’origine di un prodotto biologico quando il progetto è stato realizzato, almeno in parte, da una macchina?
Dalla previsione alla progettazione delle proteine
Per comprendere la portata della ricerca bisogna partire dalle proteine.
Queste molecole sono tra i principali strumenti operativi degli organismi viventi. Gli enzimi accelerano le reazioni chimiche, gli anticorpi riconoscono bersagli specifici, i recettori permettono alle cellule di ricevere segnali, mentre numerose proteine strutturali contribuiscono all’organizzazione dei tessuti.
Ogni proteina è costituita da una sequenza di amminoacidi. La disposizione di queste unità influenza il modo in cui la catena si ripiega nello spazio, dando origine a una struttura tridimensionale dalla quale dipendono molte delle sue proprietà.
Si può immaginare la sequenza come una frase scritta utilizzando un alfabeto di venti lettere, corrispondenti ai venti amminoacidi comunemente impiegati nella sintesi delle proteine. Cambiare una lettera può non produrre conseguenze evidenti, modificare leggermente la funzione oppure comprometterla completamente.
Per decenni, prevedere il ripiegamento di una proteina a partire dalla sua sequenza è stato uno dei grandi problemi della biologia molecolare.
L’intelligenza artificiale ha trasformato questo panorama. Sistemi come AlphaFold hanno mostrato quanto l’apprendimento automatico possa contribuire alla previsione delle strutture proteiche. Con AlphaFold 3, le capacità di modellazione si sono estese anche alle interazioni tra diverse classi di molecole biologiche.
Parallelamente sono emersi strumenti dedicati non soltanto alla previsione, ma alla progettazione di nuove proteine.
È il caso di ProteinMPNN, un modello capace di suggerire sequenze di amminoacidi compatibili con una struttura tridimensionale desiderata, e di AlphaProteo, impiegato nella progettazione di proteine capaci di legarsi a bersagli specifici.
La differenza è fondamentale: nel primo caso l’obiettivo è comprendere una molecola; nel secondo è contribuire a costruirne una nuova.
Questa evoluzione offre opportunità per la ricerca biomedica, la diagnostica e la progettazione di strumenti molecolari. Allo stesso tempo, rende necessario interrogarsi sull’origine dei risultati prodotti e sulle modalità con cui vengono verificati e condivisi.
Il problema della provenienza biologica
Quando un’immagine viene generata artificialmente, può essere utile disporre di strumenti che ne segnalino l’origine. Un’esigenza analoga riguarda documenti, contenuti multimediali e altri prodotti dell’intelligenza artificiale.
In questi ambiti si parla di watermarking, ossia dell’inserimento di una filigrana digitale riconoscibile attraverso specifici strumenti di rilevazione.
La firma non deve necessariamente essere visibile. Può consistere in una distribuzione statistica di caratteristiche che, pur non modificando sensibilmente il contenuto, permette di riconoscerne la provenienza.
Applicare lo stesso principio alle proteine è però molto più complesso.
In un testo, una parola può talvolta essere sostituita con un sinonimo senza modificare il significato generale. In una proteina, sostituire un amminoacido può alterare la stabilità della molecola, la sua struttura o la capacità di interagire con altre sostanze.
La posta in gioco, quindi, è diversa.
Una filigrana che rendesse riconoscibile una proteina ma ne compromettesse la funzione avrebbe un’utilità limitata.
La sfida affrontata da Google DeepMind consiste proprio nel conciliare due esigenze apparentemente in tensione: introdurre un segnale artificiale sufficientemente riconoscibile e preservare le proprietà che rendono biologicamente interessante la molecola.
Prima di questo studio erano già state proposte strategie per contrassegnare sequenze e strutture proteiche. Tuttavia, alcuni approcci erano stati valutati prevalentemente mediante simulazioni informatiche, mentre altri comportavano riduzioni misurabili dell’accuratezza delle strutture previste.
La novità di SynthIDBio consiste nell’affrontare esplicitamente il rapporto tra riconoscibilità e utilità biologica, includendo, per le sequenze progettate, una verifica sperimentale in laboratorio.
SynthIDBio: due firme per due rappresentazioni della biologia
Il sistema sviluppato dai ricercatori comprende due approcci distinti.
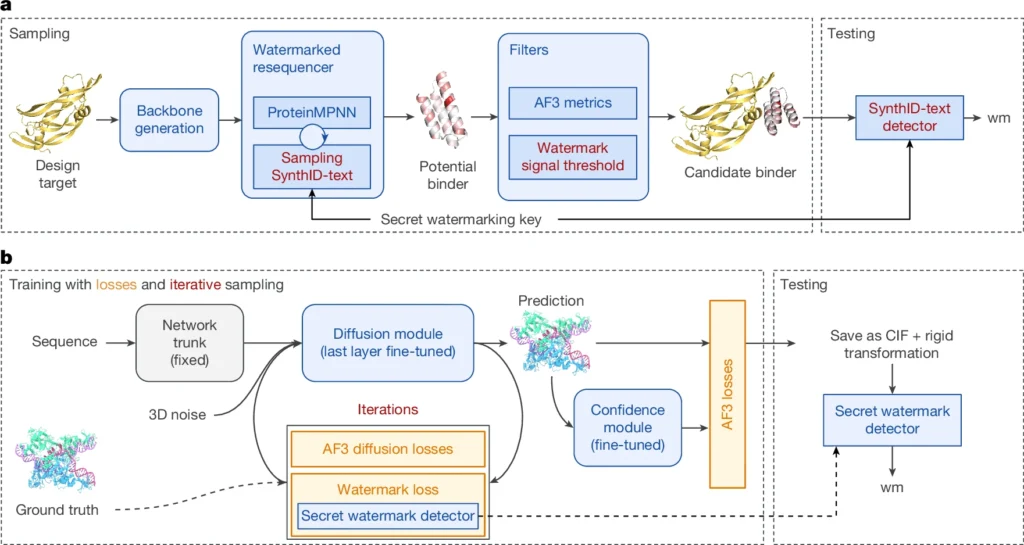
Il primo, denominato SynthIDBio-sequence, inserisce una filigrana nella successione degli amminoacidi durante la generazione di una nuova sequenza proteica.
Il secondo, SynthIDBio-structure, introduce un segnale riconoscibile nelle coordinate tridimensionali delle strutture biomolecolari previste da una versione modificata di AlphaFold 3.
La distinzione è importante.
Una sequenza descrive quali amminoacidi compongono una proteina e in quale ordine. Una struttura tridimensionale rappresenta invece la disposizione spaziale degli atomi.
Si tratta di informazioni collegate, ma non equivalenti, e richiedono tecniche di marcatura differenti.
In entrambi i casi, l’obiettivo non è aggiungere un’etichetta esterna facilmente eliminabile, bensì integrare il segnale direttamente nel risultato generato.
È una differenza simile a quella tra allegare un certificato a un documento e introdurre nel documento stesso una caratteristica verificabile.
Un’etichetta può essere separata dal contenuto. Una firma incorporata richiede invece di modificare il contenuto per tentare di cancellarla, anche se questa soluzione non garantisce che il segnale sia impossibile da rimuovere.
Come inserire una firma senza cambiare la proteina
Il funzionamento di SynthIDBio-sequence si basa su una caratteristica della progettazione proteica: per una determinata struttura tridimensionale possono esistere più sequenze compatibili.
Gli algoritmi non devono quindi scegliere sempre un’unica successione possibile di amminoacidi. Possono esplorare diverse alternative, attribuendo a ciascuna una probabilità.
I ricercatori sfruttano questa flessibilità introducendo una strategia chiamata tournament sampling, letteralmente campionamento a torneo.
Il concetto può essere spiegato attraverso un’analogia.
Immaginiamo che un compositore debba scegliere una nota all’interno di una melodia. Diverse note potrebbero funzionare, pur con probabilità differenti. Un sistema di selezione guidato da una chiave segreta potrebbe favorire alcune alternative rispetto ad altre, mantenendo il brano musicalmente coerente.
Ripetendo il procedimento, la composizione finirebbe per contenere una traccia statistica delle preferenze introdotte dal sistema.
SynthIDBio-sequence applica un principio simile alla scelta degli amminoacidi.
Partendo da una struttura proteica proposta, ProteinMPNN genera possibili sequenze. Durante questa operazione, un meccanismo guidato da una chiave segreta influenza la selezione delle alternative.
Il risultato contiene un segnale distribuito lungo la sequenza. Chi dispone della chiave corretta può analizzare la successione degli amminoacidi e verificare se presenta le caratteristiche statistiche attese.
Il procedimento non consiste dunque nell’aggiungere una sequenza arbitraria alla fine della proteina, ma nell’influenzare le scelte durante la sua progettazione.
Successivamente, i candidati vengono sottoposti a controlli computazionali per verificare sia le caratteristiche strutturali previste sia la riconoscibilità del marcatore.
Questo secondo passaggio è essenziale: non tutte le sequenze generate incorporano una firma altrettanto forte. Selezionare quelle che superano una soglia prestabilita migliora l’affidabilità della rilevazione, ma comporta anche lo scarto di una parte dei progetti.
La prova sperimentale: le proteine funzionano ancora?
Una firma riconoscibile al computer non sarebbe sufficiente a dimostrare l’utilità della tecnologia. Occorre verificare che le proteine progettate conservino le proprie proprietà biologiche.
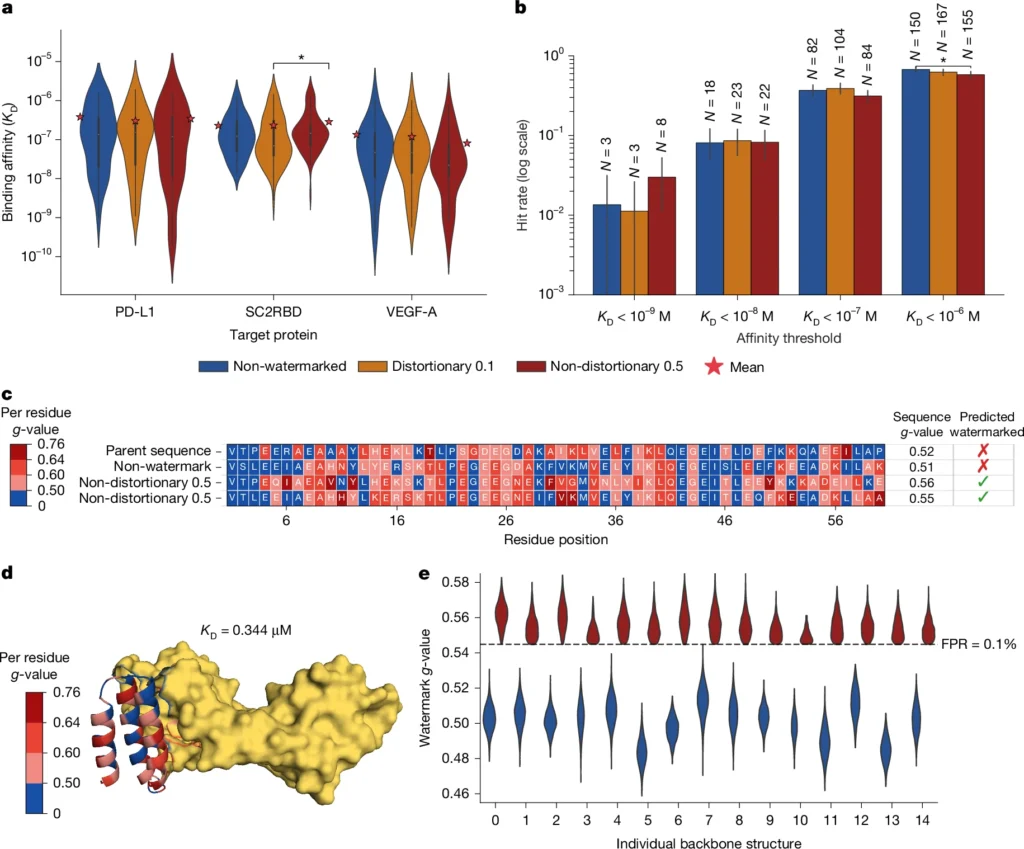
Per questo motivo, gli autori hanno condotto esperimenti in vitro, ossia al di fuori di un organismo vivente, utilizzando proteine progettate per legarsi a tre bersagli molecolari.
Il primo è il dominio di legame al recettore della proteina Spike di SARS-CoV-2, indicato come SC2RBD.
Il secondo è VEGF-A, una proteina coinvolta nella regolazione della formazione dei vasi sanguigni.
Il terzo è PD-L1, una molecola importante nei meccanismi che regolano la risposta immunitaria.
La scelta comprende quindi bersagli biologicamente diversi e rilevanti per numerosi filoni della ricerca biomedica.
Gli scienziati hanno utilizzato quindici strutture di partenza per ciascun bersaglio, selezionate da precedenti progetti AlphaProteo dei quali erano note le proprietà di legame.
A partire da queste strutture hanno generato nuove sequenze con e senza filigrana, confrontandone successivamente le prestazioni.
Complessivamente, il confronto sperimentale comprendeva 222 sequenze non marcate e 267 sequenze per ciascuna delle due configurazioni di marcatura considerate, escludendo i controlli.
Per misurare l’interazione con i bersagli è stata utilizzata la risonanza plasmonica di superficie, una tecnica capace di valutare quanto saldamente due molecole si associano.
Il parametro principale è la costante di dissociazione, indicata con KD: in termini generali, un valore più basso corrisponde a un legame più forte.
I risultati mostrano che le proteine marcate mantengono, nel complesso, affinità di legame confrontabili con quelle ottenute senza filigrana.
Le differenze nelle distribuzioni complessive dell’affinità non risultano statisticamente significative nei confronti principali. Sono però presenti differenze specifiche tra alcune configurazioni e, per una soglia di affinità meno stringente, una minore percentuale di successi in una delle condizioni sperimentali marcate.
Questo dettaglio impedisce di interpretare il risultato come una perfetta equivalenza in ogni circostanza.
La conclusione sostenuta dai dati è più precisa: nelle condizioni analizzate, la marcatura delle sequenze non determina un deterioramento sistematico dell’affinità di legame delle proteine progettate.
È un risultato importante, perché la funzionalità non è stata valutata soltanto mediante previsioni informatiche, ma attraverso misurazioni sperimentali.
Va comunque ricordato che il legame con un bersaglio rappresenta una proprietà biologica specifica, non una dimostrazione dell’assenza di qualsiasi effetto sulla stabilità, sull’attività in un organismo o sulla sicurezza della molecola.
Riconoscere la firma: precisione e falsi allarmi
Un sistema di marcatura ha valore soltanto se può essere riconosciuto con sufficiente affidabilità.
Per valutarne le prestazioni, i ricercatori utilizzano due indicatori.
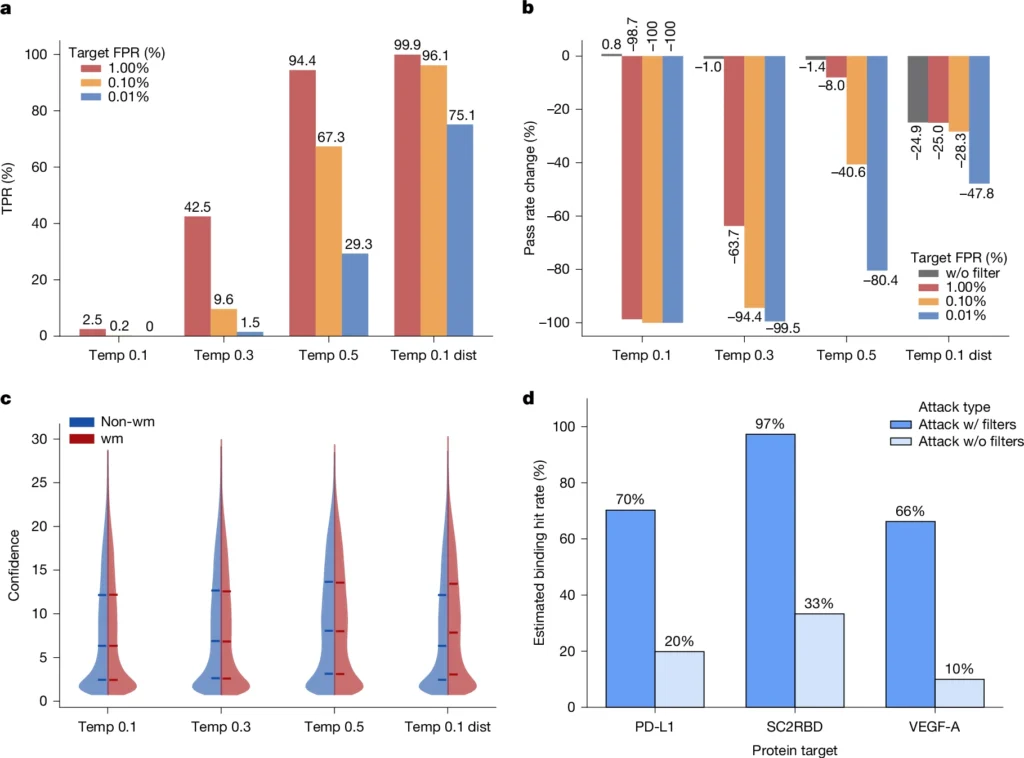
Il primo è il tasso di veri positivi: la percentuale di prodotti effettivamente marcati che il sistema riesce a identificare.
Il secondo è il tasso di falsi positivi: la percentuale di prodotti privi di filigrana che vengono erroneamente classificati come marcati.
Quest’ultimo parametro è particolarmente importante quando la tecnologia potrebbe essere utilizzata per controllare grandi archivi scientifici o processi di sintesi biologica.
Un tasso di falsi positivi dello 0,1%, per esempio, corrisponde mediamente a un falso allarme ogni mille casi non marcati, nelle condizioni in cui il rilevatore è stato calibrato e valutato.
Nel lavoro su SynthIDBio-sequence, l’introduzione di un filtro basato sull’intensità del segnale permette di ottenere il 100% di riconoscimento delle sequenze marcate che superano la soglia selezionata, al livello di falsi positivi previsto dalla calibrazione.
Il punto fondamentale è che questo risultato riguarda le sequenze effettivamente ammesse dal filtro, non qualsiasi sequenza generata dal modello.
Esiste quindi un compromesso: aumentando i requisiti di riconoscibilità, si riduce il numero di candidati utilizzabili.
Gli autori hanno studiato questo equilibrio mediante un’analisi computazionale su 23 bersagli differenti, generando 10.000 progetti per ciascuno.
In una delle configurazioni, il filtro produce una riduzione del 41,7% della percentuale di candidati che superano i controlli. Per ottenere lo stesso numero di progetti accettati occorre quindi generarne circa il 71,5% in più.
Nonostante ciò, gli autori riferiscono che il costo computazionale aggiuntivo può rimanere trascurabile nella loro procedura, perché la verifica della filigrana permette di escludere precocemente i candidati, prima delle analisi strutturali più onerose.
La firma digitale, dunque, non è completamente gratuita: la sua affidabilità dipende da scelte operative che devono bilanciare qualità, riconoscibilità e risorse necessarie.
Una filigrana nascosta anche nella struttura tridimensionale
Il secondo componente della ricerca affronta un problema differente.
SynthIDBio-structure non interviene sulla sequenza degli amminoacidi, ma sulle strutture tridimensionali generate attraverso un modello derivato da AlphaFold 3.
In una rappresentazione tridimensionale, ogni atomo possiede coordinate spaziali. Modificare queste coordinate significa intervenire sulla geometria della molecola, un’operazione che deve essere effettuata con estrema cautela.
I ricercatori hanno modificato l’addestramento di una parte del modello, introducendo un ulteriore obiettivo: produrre strutture accurate che contengano caratteristiche geometriche riconoscibili da un rilevatore dedicato.
Il principio ricorda quello di una filigrana incorporata nella trama di un’immagine digitale.
Un’immagine può apparire identica all’osservatore pur contenendo variazioni minime, identificabili attraverso un opportuno algoritmo. Analogamente, una struttura molecolare può includere minuscole variazioni geometriche associate a una firma statistica.
Nel sistema studiato, il segnale interessa caratteristiche come le distanze tra atomi e alcuni angoli della struttura.
Il modello viene addestrato a conservare l’accuratezza della previsione e, contemporaneamente, a rendere identificabili le strutture prodotte.
I risultati sono particolarmente interessanti.
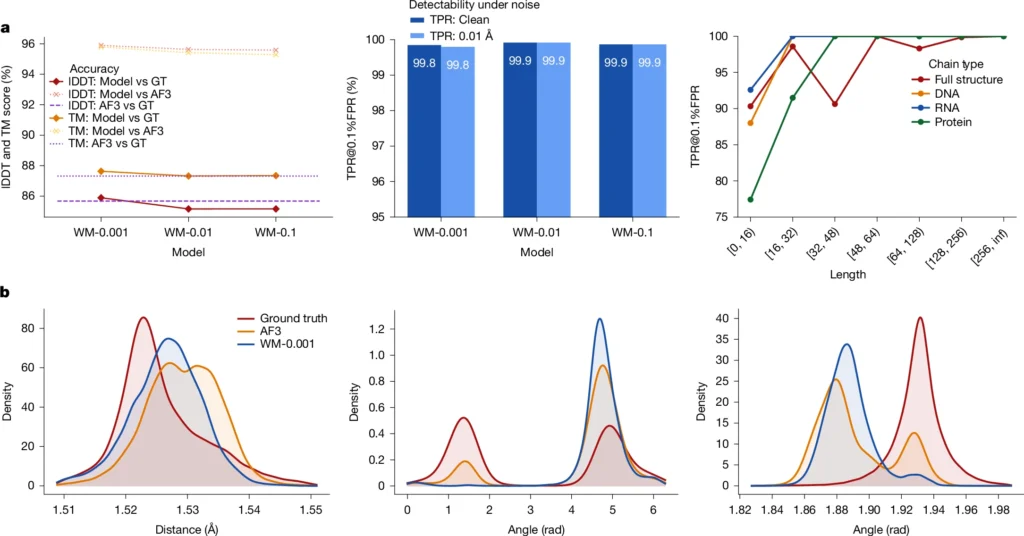
Nelle valutazioni effettuate dagli autori, il riconoscimento supera il 99,8%, con un tasso di falsi positivi fissato allo 0,1%, per tutte e tre le configurazioni principali esaminate.
Nella configurazione raccomandata, le metriche globali di accuratezza strutturale non risultano inferiori a quelle del modello AlphaFold 3 utilizzato come riferimento.
Le alterazioni introdotte sono quindi sufficienti a permettere il riconoscimento, ma abbastanza contenute da non determinare un peggioramento misurabile delle principali metriche considerate.
Il metodo è stato valutato anche su strutture comprendenti RNA e DNA, oltre alle proteine, con risultati generalmente elevati, sebbene la rilevazione sia meno efficace per strutture molto corte.
Questo amplia il potenziale interesse dell’approccio, senza trasformarlo automaticamente in una soluzione universale per qualsiasi molecola biologica.
È inoltre importante distinguere la precisione geometrica dalla funzione biologica: per SynthIDBio-structure gli autori hanno verificato soprattutto l’accuratezza delle strutture previste, non il comportamento sperimentale di ogni molecola rappresentata.
Una firma resistente, ma non impossibile da cancellare
La robustezza è uno dei problemi principali di qualsiasi sistema di watermarking.
Una firma che scompare dopo una modifica banale avrebbe un’applicabilità limitata. D’altra parte, pretendere che nessuna trasformazione possa eliminarla sarebbe irrealistico.
Gli autori hanno quindi esaminato diversi modi per alterare i prodotti marcati.
Nel caso delle strutture tridimensionali, il sistema resiste a semplici rotazioni e traslazioni nello spazio. È un risultato coerente con il funzionamento del rilevatore, che utilizza relazioni geometriche non dipendenti dall’orientamento assoluto della molecola.
La filigrana mostra anche una buona resistenza a piccole perturbazioni casuali delle coordinate.
Esistono tuttavia procedure capaci di comprometterla. In particolare, gli esperimenti di rilassamento strutturale, nei quali la geometria viene ri-ottimizzata mediante un modello fisico, riescono a cancellare il segnale.
Per le sequenze proteiche emerge un’altra vulnerabilità.
Una proteina marcata può essere sottoposta a un nuovo processo di progettazione della sequenza, utilizzando ProteinMPNN. Questa operazione, chiamata resequencing, può produrre una successione diversa di amminoacidi che conserva almeno in parte le caratteristiche della proteina iniziale.
Nelle simulazioni condotte su 38.396 proteine leganti, questa strategia si è dimostrata efficace nell’eliminare la filigrana.
Tuttavia, la rielaborazione introduce anche il rischio di perdere le proprietà desiderate.
Gli autori stimano, in base ai risultati sperimentali disponibili, che la probabilità di mantenere un legame utile possa diminuire sensibilmente, soprattutto quando non vengono applicati ulteriori controlli strutturali.
La vulnerabilità non viene quindi eliminata, ma può rendere la cancellazione della firma più onerosa e meno prevedibile.
Rimane un limite decisivo: un soggetto intenzionato a evitare la marcatura potrebbe scegliere fin dall’inizio strumenti che non utilizzano SynthIDBio.
Per questo la tecnologia non deve essere interpretata come un sistema infallibile di controllo delle proteine artificiali.
Biosicurezza: conoscere l’origine non significa conoscere il rischio
Una delle applicazioni considerate dagli autori riguarda la biosicurezza, cioè l’insieme delle pratiche volte a prevenire l’uso improprio delle conoscenze e delle tecnologie biologiche.
Le aziende che sintetizzano acidi nucleici su richiesta possono sottoporre gli ordini a procedure di controllo, confrontando le sequenze con informazioni relative a materiali biologici potenzialmente pericolosi.
L’evoluzione dei sistemi generativi rende questa attività più complessa, perché nuove sequenze possono essere molto diverse da quelle già conosciute pur conservando proprietà biologiche rilevanti.
Una firma digitale potrebbe fornire un’informazione supplementare: indicare che una determinata sequenza è stata generata mediante uno strumento di progettazione identificabile e sottoposto a specifiche procedure di verifica.
Questo potrebbe aiutare a organizzare i controlli, soprattutto se sviluppatori, laboratori e aziende di sintesi adottassero protocolli condivisi.
Ma occorre evitare un equivoco.
Una proteina marcata non è necessariamente sicura, così come una proteina priva di marcatura non è necessariamente pericolosa.
La filigrana fornisce un’indicazione di provenienza, non una valutazione diretta delle proprietà biologiche o del potenziale rischio.
Gli stessi ricercatori insistono sulla necessità di utilizzare la marcatura come parte di un sistema di controlli stratificato, senza sostituire le verifiche biologiche e le procedure di sicurezza già esistenti.
Anche una firma autentica, infatti, non potrebbe escludere automaticamente modifiche successive o l’aggiunta di componenti non verificati.
Proteggere l’affidabilità degli archivi scientifici
Un secondo ambito di applicazione riguarda l’integrità dell’informazione scientifica.
La ricerca biologica contemporanea dipende da grandi banche dati pubbliche, nelle quali vengono conservate sequenze genetiche, informazioni sulle proteine e strutture molecolari.
Archivi come Protein Data Bank, UniProt e GenBank costituiscono infrastrutture essenziali per la biologia computazionale.
Questi sistemi permettono ai ricercatori di confrontare risultati, formulare ipotesi e sviluppare nuovi modelli predittivi.
La loro utilità dipende però anche dalla qualità delle informazioni contenute.
Con la crescente diffusione dell’intelligenza artificiale generativa, diventa possibile produrre grandi quantità di sequenze plausibili. Se tali contenuti venissero inseriti negli archivi con descrizioni inesatte o informazioni fuorvianti, potrebbero complicare la ricerca e compromettere l’affidabilità di successive analisi.
La presenza di una firma riconoscibile potrebbe aiutare i responsabili delle banche dati a identificare materiale generato mediante specifici strumenti di intelligenza artificiale e a sottoporlo, quando necessario, a controlli ulteriori.
L’obiettivo non sarebbe impedire l’inserimento di proteine progettate artificialmente. Queste rappresentano infatti una risorsa legittima e potenzialmente preziosa per la ricerca.
Il problema è assicurare che siano accompagnate da informazioni corrette sulla loro origine e sulle verifiche effettuate.
La marcatura potrebbe così contribuire a distinguere con maggiore chiarezza i risultati sperimentali dalle previsioni computazionali e dai prodotti della progettazione generativa.
Anche in questo contesto, tuttavia, il sistema avrebbe bisogno di standard condivisi e procedure di verifica affidabili.
I limiti: dalla dimostrazione alla pratica
Nonostante i risultati promettenti, SynthIDBio rimane una dimostrazione di fattibilità tecnologica.
Gli autori lo definiscono esplicitamente un proof of concept: una prova che l’approccio può funzionare, non una garanzia della sua applicabilità universale.
Le verifiche sperimentali sulle sequenze hanno riguardato una classe specifica di proteine progettate per riconoscere bersagli molecolari. Inoltre, i ricercatori sono partiti da strutture già associate a proteine leganti note, anziché svolgere una progettazione completamente nuova dall’inizio alla fine.
Questa scelta ha permesso di raccogliere dati sperimentali utili, ma limita l’estensione immediata delle conclusioni ad altre famiglie proteiche o ad altre funzioni biologiche.
Non è stato dimostrato, per esempio, che la stessa strategia conservi sempre l’attività di enzimi complessi, la stabilità di ogni proteina terapeutica o il comportamento delle molecole all’interno di organismi viventi.
Un secondo limite riguarda la quantità di informazioni contenute nella firma.
Nelle versioni presentate, la marcatura funziona principalmente come un segnale binario: consente di rilevare la presenza di una filigrana riconoscibile, ma non costituisce un sistema generale capace di registrare automaticamente identità dell’autore, data, laboratorio e intera storia delle modifiche.
Per ricostruire una provenienza dettagliata sarebbero necessari ulteriori meccanismi.
Un terzo problema è la gestione delle chiavi di rilevazione.
Poiché queste devono essere protette per ridurre i rischi di falsificazione, l’adozione della tecnologia richiederebbe accordi tra sviluppatori, organizzazioni scientifiche e soggetti incaricati dei controlli.
Infine, la presenza di attacchi capaci di rimuovere il segnale impone ulteriore ricerca sulla robustezza delle filigrane e sulle conseguenze delle modifiche successive.
I dati disponibili dimostrano quindi che è possibile coniugare marcatura e preservazione di specifiche proprietà biologiche, ma non che la provenienza di qualsiasi prodotto molecolare possa essere accertata in tutte le circostanze.
Verso una biologia artificiale più tracciabile
L’interesse di SynthIDBio va oltre la soluzione tecnica sviluppata dagli autori.
La ricerca affronta una trasformazione più generale: la progressiva integrazione dell’intelligenza artificiale nei processi attraverso i quali vengono immaginate, progettate e studiate nuove molecole biologiche.
In passato, la documentazione di una procedura sperimentale permetteva almeno in parte di ricostruire le scelte compiute da un ricercatore. Oggi, una parte crescente di queste decisioni può essere affidata a sistemi computazionali capaci di esplorare possibilità difficilmente accessibili attraverso metodi tradizionali.
Diventa perciò importante sviluppare strumenti che permettano di collegare i risultati agli strumenti utilizzati, senza ostacolare la ricerca e senza compromettere le proprietà delle molecole.
SynthIDBio suggerisce che questo obiettivo è tecnicamente perseguibile.
Il lavoro mostra che una sequenza di amminoacidi può contenere un segnale statistico riconoscibile continuando a svolgere la funzione di legame per cui è stata progettata. Dimostra inoltre che un sistema avanzato di previsione strutturale può produrre coordinate tridimensionali marcate mantenendo elevate prestazioni secondo le metriche considerate.
La prospettiva è quella di una tracciabilità incorporata fin dalla fase di progettazione, anziché affidata esclusivamente a documenti esterni.
Per trasformare questa possibilità in uno strumento di uso comune serviranno ulteriori esperimenti, standard tecnici, forme di collaborazione e un’attenta valutazione dei rischi di interpretazione.
La filigrana non potrà sostituire la sperimentazione, la verifica indipendente o la responsabilità scientifica. Potrà però diventare un’informazione aggiuntiva utile per comprendere la provenienza di alcuni prodotti dell’ingegneria biologica.
In definitiva, la domanda sollevata dallo studio non riguarda soltanto ciò che l’intelligenza artificiale riuscirà a progettare, ma anche come saremo in grado di riconoscere e documentare i suoi contributi.
In una biologia nella quale le molecole possono nascere da algoritmi sempre più sofisticati, sapere come un risultato è stato generato potrebbe diventare importante quasi quanto conoscerne la struttura e la funzione.