Un gruppo di ricercatori di Stanford ha sviluppato Paper2Agent, un sistema capace di trasformare articoli scientifici, codice, dati e procedure in agenti di intelligenza artificiale interrogabili in linguaggio naturale. L’obiettivo non è affidare alla macchina il giudizio scientifico, ma ridurre una delle barriere più concrete della ricerca contemporanea: passare dalla lettura di un metodo alla sua effettiva riproduzione e applicazione.
Un biologo legge un nuovo articolo e scopre un metodo potenzialmente utile per i propri dati. Il principio è chiaro, i risultati convincenti. Poi comincia la parte difficile: trovare il repository corretto, installare le dipendenze software, capire quali file fornire in ingresso, configurare l’ambiente, interpretare le opzioni del programma e infine verificare che ciò che sta eseguendo corrisponda davvero all’analisi descritta dagli autori.
In altre parole, tra conoscere un metodo scientifico e riuscire a usarlo può esserci una distanza sorprendentemente grande.
È proprio questa distanza che Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard e James Zou, della Stanford University, cercano di ridurre con Paper2Agent, il sistema presentato in un articolo su Nature intitolato Reimagining research papers as interactive and reliable AI agents. L’idea è radicale ma intuitiva: anziché considerare un articolo come un documento da leggere, trasformarlo in una sorta di esperto digitale operativo, capace non soltanto di spiegare il lavoro, ma anche di utilizzare gli strumenti software associati allo studio.
Non significa che il paper “diventi intelligente” né che l’AI sostituisca gli autori. Significa piuttosto costruire attorno alla pubblicazione un’interfaccia che permetta a un agente AI di accedere in modo strutturato al manoscritto, al codice, ai dati supplementari e alle procedure computazionali validate.
Il risultato assomiglia meno a un PDF con una chatbot accanto e molto più a un laboratorio software conversazionale.
Miao, J., Davis, J.R., Zhang, Y. et al. Reimagining research papers as interactive and reliable AI agents. Nature (2026). https://doi.org/10.1038/s41586-026-11044-y
Il problema dei paper che sappiamo leggere ma non sempre usare
L’articolo scientifico è ancora l’unità fondamentale attraverso cui la ricerca comunica metodi, risultati e interpretazioni. Ma è, per sua natura, un oggetto passivo.
Un lettore deve trovarlo, comprenderlo e infine capire autonomamente come trasferirne i metodi al proprio problema. Quando lo studio presenta un nuovo strumento computazionale, questa fase può richiedere competenze considerevoli: installazione di software, gestione delle librerie, API, configurazioni, formati dei dati e parametri.
Gli autori citano come esempio AlphaGenome, un modello per prevedere gli effetti funzionali delle varianti genetiche. Per utilizzarlo direttamente via codice bisogna conoscere la sua API, costruire correttamente gli oggetti che rappresentano le varianti, selezionare i tipi di predizione desiderati e comprendere la struttura del sistema. Tutte operazioni perfettamente normali per uno sviluppatore esperto, ma potenzialmente scoraggianti per un biologo che voglia semplicemente interrogare il modello.
Negli anni si è già cercato di rendere la ricerca computazionale più riproducibile: notebook eseguibili, repository collegati agli articoli, iniziative come Papers with Code, ambienti containerizzati come Binder e CodeOcean.
Paper2Agent prova a compiere un passo ulteriore.
Non chiede soltanto di rendere disponibile il codice: cerca di trasformarlo in strumenti direttamente utilizzabili da un agente AI attraverso il linguaggio naturale.
È una differenza sostanziale.
Un repository tradizionale dice, in sostanza: “Ecco il programma, imparane il funzionamento”.
Un agente costruito con Paper2Agent punta invece a consentire richieste del tipo: applica il metodo descritto in questo articolo al mio dataset.
Dal PDF a un “autore corrispondente virtuale”
Gli autori descrivono il paper agent come una sorta di virtual corresponding author, un “autore corrispondente virtuale”. È una metafora efficace, purché non venga presa troppo alla lettera.
Il sistema non possiede l’esperienza degli autori e non ne sostituisce il giudizio. Può però rendere interrogabili e utilizzabili le componenti tecniche della ricerca.
Il cuore dell’architettura è il Model Context Protocol, o MCP. In termini semplici, MCP è uno standard che permette a un modello linguistico di sapere quali strumenti esterni può utilizzare, quali parametri richiedono e quali risorse sono disponibili.
Si può immaginarlo come una presa universale tra l’AI e il software scientifico.
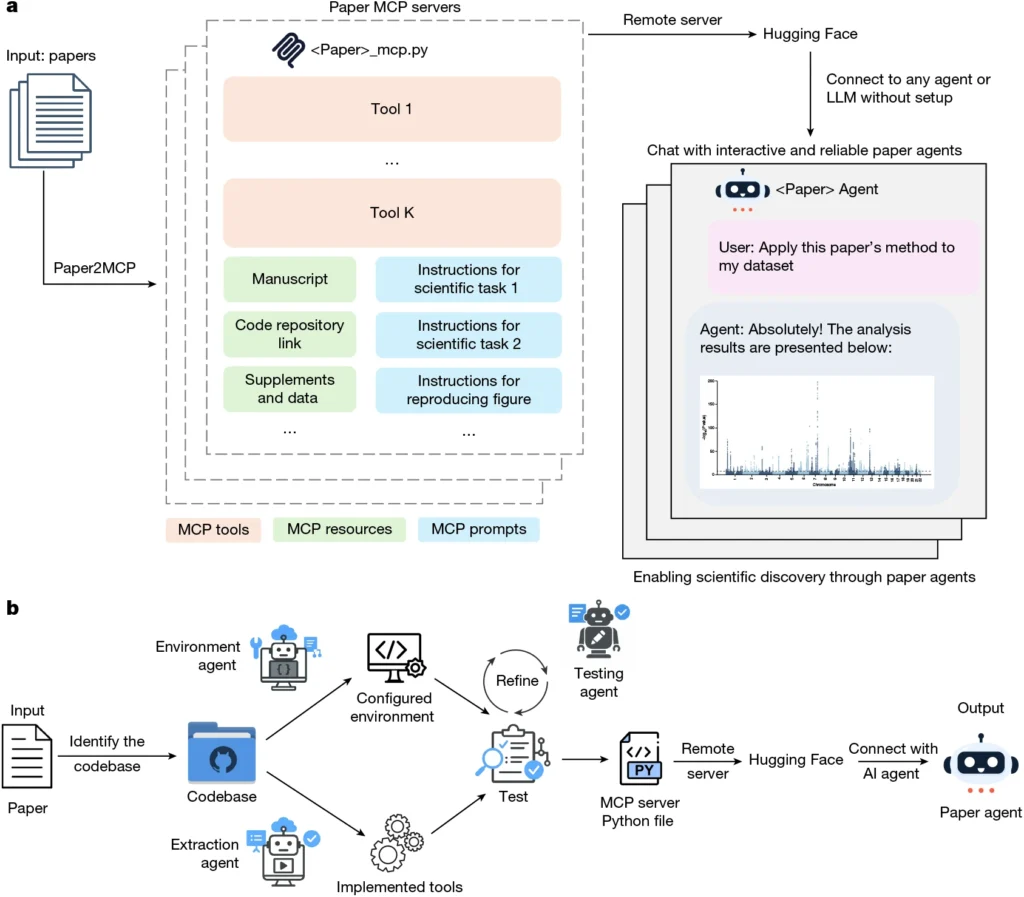
Paper2Agent analizza articolo e repository e costruisce un server MCP dedicato a quel lavoro. Il diagramma di una figura contenuta nel paper (figura 1) mostra bene questa trasformazione: dal manoscritto e dal codice vengono ricavati strumenti eseguibili, risorse informative e istruzioni operative; successivamente il server MCP viene collegato a un agente conversazionale.
Il sistema organizza il contenuto in tre categorie.
Gli strumenti sono vere funzioni eseguibili: per esempio, una funzione che prende una variante genetica e calcola le conseguenze previste sulla regolazione dei geni.
Le risorse comprendono invece manoscritto, supplementi, codice, dataset e documentazione.
Infine ci sono i prompt MCP, che codificano procedure più articolate: una sorta di ricetta operativa che stabilisce in quale ordine devono essere eseguiti diversi passaggi di un’analisi.
La differenza rispetto a chiedere semplicemente a un chatbot di “scrivere il codice” è importante.
Il punto cruciale: non lasciare che l’AI inventi il metodo
Uno dei rischi più evidenti dell’uso dei modelli linguistici nella scienza è la cosiddetta allucinazione: il sistema può produrre risposte plausibili o codice apparentemente corretto che, in realtà, non corrisponde al metodo originale.
Paper2Agent cerca di limitare proprio questo problema.
Il processo utilizza diversi agenti specializzati. Un agente configura l’ambiente software; un altro individua nel repository le funzioni rilevanti e le trasforma in strumenti MCP; un terzo esegue test automatici.
Uno strumento viene accettato soltanto se supera le verifiche previste: devono essere generati i file attesi, i risultati numerici devono rientrare nelle tolleranze stabilite e le figure devono essere coerenti con quelle di riferimento. Gli strumenti che falliscono ripetutamente vengono esclusi.
È un principio importante: l’AI non dovrebbe reinventare ogni volta il programma scientifico, ma utilizzare una versione già testata e stabilizzata dello strumento.
Ogni tool conserva inoltre un riferimento al codice originale, in modo da mantenere tracciabilità tra ciò che l’agente esegue e la sorgente dalla quale è stato ricavato.
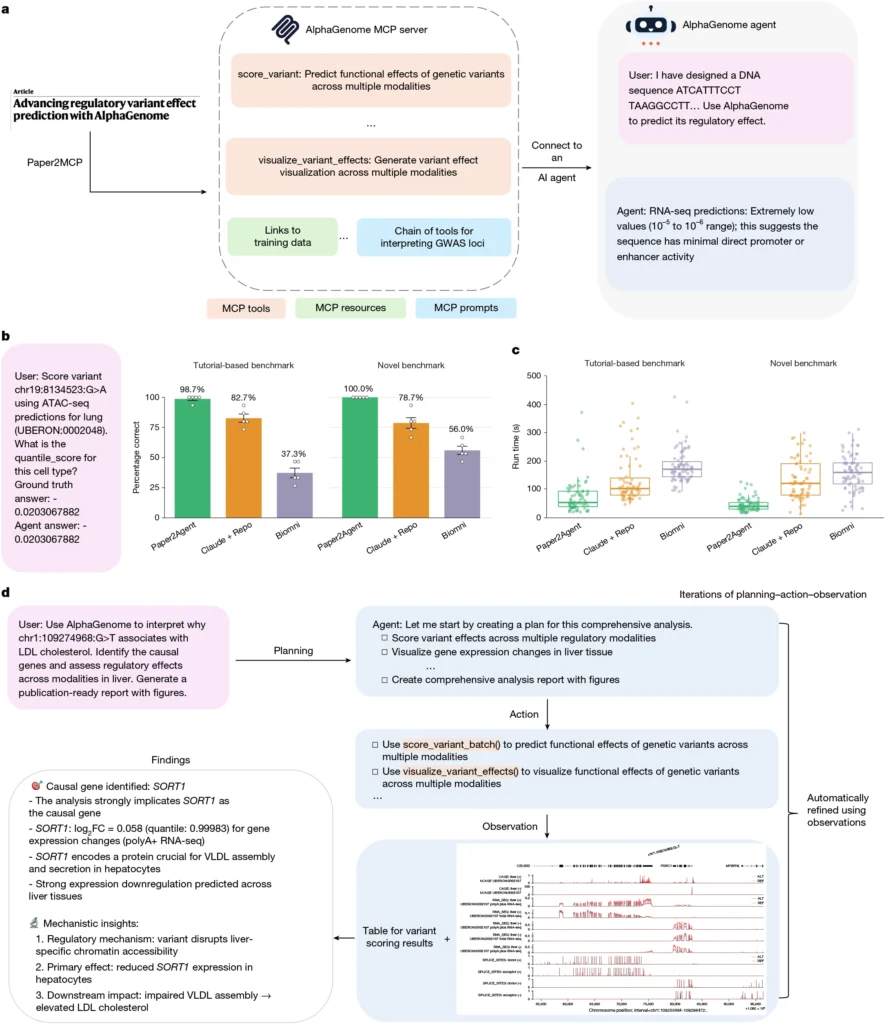
b, Accuratezza dei benchmark. I dati sono espressi come media ± s.e.m.; n = 5 esecuzioni indipendenti. I punti rappresentano le singole esecuzioni. c, Tempi di esecuzione delle query. Le linee centrali indicano le mediane, i riquadri delimitano i percentili dal 25° al 75°, i baffi si estendono fino ai valori più estremi entro 1,5 volte l’intervallo interquartile e i punti oltre i baffi rappresentano i valori anomali.
n = 75 esecuzioni di query per metodo per benchmark (15 query in 5 esecuzioni indipendenti). d, Pianificazione e interpretazione automatizzate dei loci GWAS attraverso cicli iterativi di pianificazione–azione–osservazione.
Il banco di prova del genoma
Per verificare il sistema, i ricercatori hanno cominciato proprio da AlphaGenome.
Paper2Agent ha prodotto automaticamente 22 strumenti MCP, tutti validati, in circa 45 minuti. Secondo gli autori, il processo è costato circa 14 dollari ed è stato eseguito su un laptop personale senza intervento umano durante la conversione.
Gli strumenti permettono, tra le altre cose, di analizzare singole varianti genetiche o gruppi di varianti e di visualizzarne gli effetti previsti sull’espressione dei geni, sullo splicing e sull’accessibilità della cromatina.
La domanda decisiva era però un’altra: il nuovo agente avrebbe fornito risultati affidabili?
Nei test derivati dai tutorial di AlphaGenome, l’agente Paper2Agent ha ottenuto in cinque esecuzioni indipendenti un’accuratezza media del 98,7%. Su una seconda serie di domande nuove ha raggiunto il 100% nel benchmark utilizzato dagli autori.
Un agente generalista dotato semplicemente di accesso al repository — indicato nello studio come Claude + Repo — ha ottenuto rispettivamente l’82,7% e il 78,7%; un altro sistema, Biomni, il 37,3% e il 56%.
Su trenta domande più aperte, che richiedevano più passaggi di analisi e interpretazione biologica, Paper2Agent ha raggiunto invece l’82,7%.
Questo dato è forse più interessante del 100% ottenuto nei compiti più circoscritti: mostra che, quando si passa dall’esecuzione relativamente deterministica di un metodo all’interpretazione scientifica, il problema rimane molto più difficile.
Quando l’agente non si limita a riprodurre il paper
Una dimostrazione particolarmente istruttiva riguarda una variante genetica associata al colesterolo LDL.
L’agente ha costruito autonomamente un piano: preparazione degli input, analisi delle varianti, selezione dei tessuti pertinenti, produzione delle visualizzazioni e compilazione di un rapporto interpretativo.
A quel punto è successo qualcosa di scientificamente interessante.
L’articolo originale di AlphaGenome aveva dato particolare rilievo ai geni CELSR2 e PSRC1. L’agente Paper2Agent ha invece indicato SORT1 come candidato causale più probabile.
Non si trattava però di una semplice “correzione dell’AI”. Gli stessi autori sottolineano che tutti e tre i geni mostrano forti segnali e associazioni significative, evidenziando quanto sia difficile assegnare con certezza causalità nei loci genetici complessi.
L’esempio mostra piuttosto una delle possibilità offerte dal sistema: un risultato pubblicato può essere riesaminato rapidamente attraverso nuove combinazioni di evidenze, invece di rimanere un’interpretazione cristallizzata nel testo.
Ed è qui che Paper2Agent comincia a diventare qualcosa di più di un’interfaccia comoda.
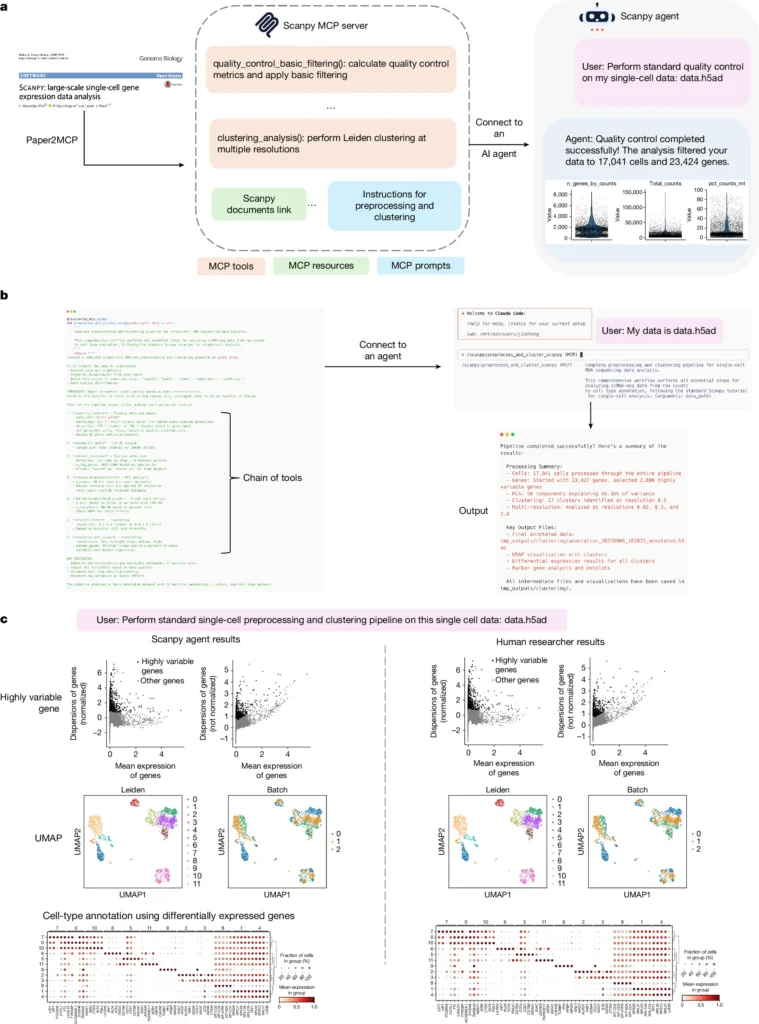
Una pipeline single-cell raccontata in linguaggio naturale
Il secondo esempio riguarda Scanpy, uno degli strumenti più utilizzati per l’analisi dei dati di trascrittomica a singola cellula.
Questi esperimenti misurano quali geni sono attivi in migliaia o milioni di singole cellule. Prima di arrivare a un risultato interpretabile occorre però attraversare numerosi passaggi: controllo qualità, filtraggio, normalizzazione, selezione delle caratteristiche più informative, riduzione della dimensionalità, costruzione di grafi, clustering e identificazione dei tipi cellulari.
L’ordine conta.
Paper2Agent ha ricavato sette strumenti relativi a queste operazioni e ha costruito automaticamente istruzioni capaci di concatenarli nella sequenza appropriata. L’utente può quindi fornire semplicemente il percorso del proprio dataset e chiedere di eseguire la pipeline standard.
Su quattro dataset pubblici non inclusi nel repository originale di Scanpy, i risultati dell’agente hanno riprodotto quelli ottenuti dai ricercatori umani utilizzando parametri corrispondenti: numeri equivalenti di cellule e geni dopo il controllo qualità e marcatori differenzialmente espressi equivalenti nei cluster. Altri sette dataset sono stati utilizzati per verificare la capacità del sistema di adattare i parametri alle caratteristiche dei dati.
Obiettivo: da un lato la complessa pipeline di analisi, dall’altro una richiesta in linguaggio naturale e risultati molto simili a quelli ottenuti manualmente.
Funziona soltanto negli esempi scelti dagli autori?
È la domanda inevitabile per ogni nuova tecnologia AI.
Per affrontarla, il gruppo ha effettuato un esperimento su scala maggiore: 100 articoli di biologia computazionale, 26 lavori centrati soprattutto su dati e scoperte e 10 articoli computazionali di altri settori, tra cui statistica, econometria, teoria dei giochi e astrofisica.
Dei 100 paper di biologia computazionale, 74 sono stati convertiti con successo in agenti. Il sistema ha proposto 599 strumenti, 593 dei quali hanno superato la validazione automatica.
I fallimenti sono istruttivi quanto i successi: codice mancante, dati o modelli non disponibili, dipendenze impossibili da ricostruire, ambienti software problematici oppure script troppo specifici per essere trasformati in strumenti generalizzabili.
Su 300 domande derivate dai tutorial, Paper2Agent ha raggiunto un’accuratezza media del 91,2%, rispetto all’80,3% dell’agente con accesso diretto al repository nella configurazione principale del confronto. Gli autori riportano inoltre costi e tempi medi inferiori per interrogazione. Nei 42 compiti esecutivi ricavati dai dieci paper non biologici, l’accuratezza media riportata è stata del 98,1%.
Questi numeri non dimostrano che qualunque articolo possa essere trasformato automaticamente in un assistente impeccabile. Dimostrano invece qualcosa di più circoscritto ma significativo: il paradigma sembra funzionare su classi abbastanza diverse di ricerca computazionale da meritare attenzione oltre i singoli casi dimostrativi.
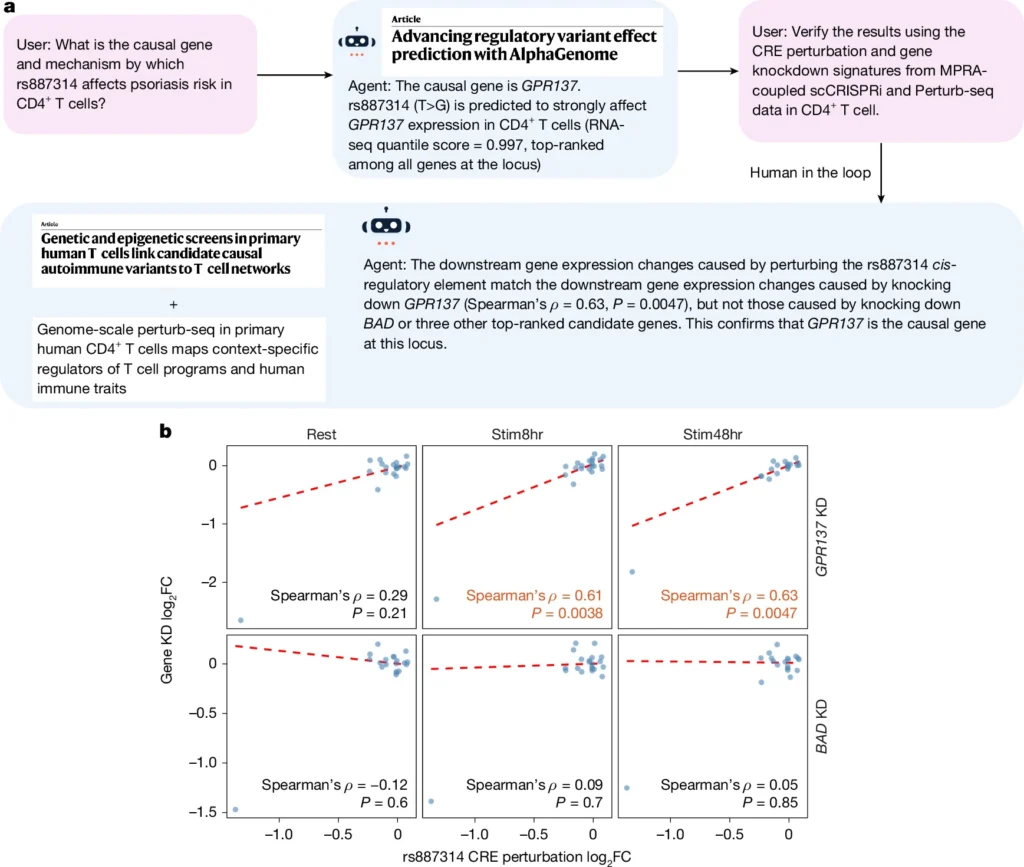
a, Paper2Agent integra gli agenti AlphaGenome, scCRISPRi accoppiato a MPRA e Perturb-seq per dare priorità al gene GPR137 nel locus rs887314 associato alla psoriasi. b, Correlazioni tra la perturbazione CRE di rs887314 e le firme di knockdown (KD) genico. Ogni punto rappresenta un gene a valle. n = 20 (Riposo); n = 21 (Stimolazione 8 ore); n = 19 (Stimolazione 48 ore). Sono riportati il coefficiente ρ di Spearman e i valori P bilaterali; correzione di Benjamini–Hochberg (arancione, FDR < 0,05). Le linee tratteggiate mostrano gli adattamenti lineari dopo la rimozione dei valori anomali. Il gene perturbato è stato escluso.
E se gli agenti scientifici cominciassero a collaborare?
Il passaggio forse più ambizioso dello studio arriva quando gli autori collegano più paper agent.
Nella ricerca tradizionale, uno scienziato può leggere un articolo che propone un modello, un secondo che contiene un dataset e un terzo che offre un esperimento di validazione, per poi tentare di integrare queste fonti in una nuova analisi.
Paper2Agent prova ad automatizzare parte di questo lavoro.
Gli autori hanno collegato tre agenti basati su AlphaGenome, su uno studio scCRISPRi e su un dataset Perturb-seq, chiedendo al sistema di indagare una variante genetica associata alla psoriasi.
AlphaGenome ha indicato GPR137 come candidato principale nel locus studiato. L’agente ha poi confrontato questa previsione con due dataset sperimentali indipendenti. In condizioni di stimolazione delle cellule T CD4+, la firma prodotta dalla perturbazione dell’elemento regolatorio mostrava una correlazione significativa con quella osservata riducendo l’espressione di GPR137; lo stesso segnale non emergeva a riposo.
Il dato non equivale a una dimostrazione definitiva che GPR137 sia “il gene della psoriasi”. Il risultato riguarda uno specifico locus e un preciso contesto cellulare, e gli stessi autori parlano prudentemente di supporto alla sua identificazione come probabile gene causale.
Ma c’è un aspetto ancora più interessante: la strategia di integrazione utilizzata — correlare le firme di perturbazione regolatoria con quelle ottenute dal knockdown dei geni — non era stata proposta nei lavori originali. È emersa dalla combinazione operativa dei diversi agenti.
È forse questa la visione più suggestiva del lavoro: non tanti chatbot che riassumono articoli, ma moduli scientifici specializzati che possono mettere in relazione metodi e dati provenienti da studi differenti.
Ciò che Paper2Agent non risolve
È però proprio a questo punto che serve maggiore prudenza.
Paper2Agent funziona bene soltanto quando trova materiale abbastanza solido da cui partire. Nel test su cento studi di biologia computazionale, circa un quarto non è stato trasformato con successo in un agente completo. Repository incompleti, documentazione insufficiente e ambienti software non ricostruibili rimangono ostacoli sostanziali.
Paradossalmente, questo potrebbe diventare esso stesso un indicatore utile: se un articolo non può essere trasformato in un sistema capace di rieseguire il metodo, forse ci sono problemi nella sua riproducibilità computazionale.
C’è poi un secondo limite ancora più importante.
Un agente può eseguire un’analisi e può persino suggerire ipotesi. Ma eseguire fedelmente un metodo non equivale a stabilire la verità scientifica.
Gli stessi autori insistono sul mantenimento del human-in-the-loop: sono i ricercatori a scegliere quali direzioni seguire, a giudicare la qualità dell’evidenza e a valutare le interpretazioni. Nei problemi aperti possono esistere più risposte ragionevoli; un benchmark che verifica quanto l’agente concordi con una risposta prestabilita misura quindi soprattutto la fedeltà dell’esecuzione, non necessariamente la validità scientifica dell’interpretazione.
Restano inoltre questioni tutt’altro che secondarie: sicurezza nell’esecuzione di codice, proprietà intellettuale, attribuzione dei risultati e manutenzione degli agenti quando librerie e dipendenze cambiano nel tempo.
Un paper agent, insomma, non è un manufatto che si pubblica una volta e rimane valido per sempre.
È software. E il software invecchia.
Dalla “data availability” alla “agent availability”?
Nella parte conclusiva dell’articolo, i ricercatori immaginano un’evoluzione curiosa delle pubblicazioni scientifiche.
Oggi molte riviste chiedono agli autori di specificare dove siano disponibili dati e codice. In futuro, suggeriscono, potrebbe comparire anche una sezione “agent availability”: un’indicazione dell’esistenza di una versione interattiva ed eseguibile del lavoro.
È prematuro sapere se accadrà davvero.
Ma l’idea mette a fuoco una trasformazione più ampia già in corso: un articolo scientifico potrebbe non essere più soltanto la descrizione finale di un esperimento, ma il punto di accesso a un insieme di strumenti capaci di riprodurlo, interrogarlo e applicarlo a nuovi dati.
Per secoli abbiamo costruito la comunicazione scientifica attorno a una domanda: “Che cosa hanno scoperto gli autori?”
Con sistemi come Paper2Agent potrebbe diventare altrettanto naturale chiedere: “Che cosa posso fare, adesso, con ciò che hanno scoperto?”
La differenza sembra piccola. In realtà riguarda il confine tra conoscenza scientifica pubblicata e conoscenza scientifica operativa.
E forse è proprio lì che l’intelligenza artificiale può offrire uno dei suoi contributi più interessanti alla ricerca: non sostituire lo scienziato che decide che cosa credere, ma accorciare drasticamente il percorso che separa un’idea pubblicata dalla possibilità di verificarla, riutilizzarla e metterla alla prova.